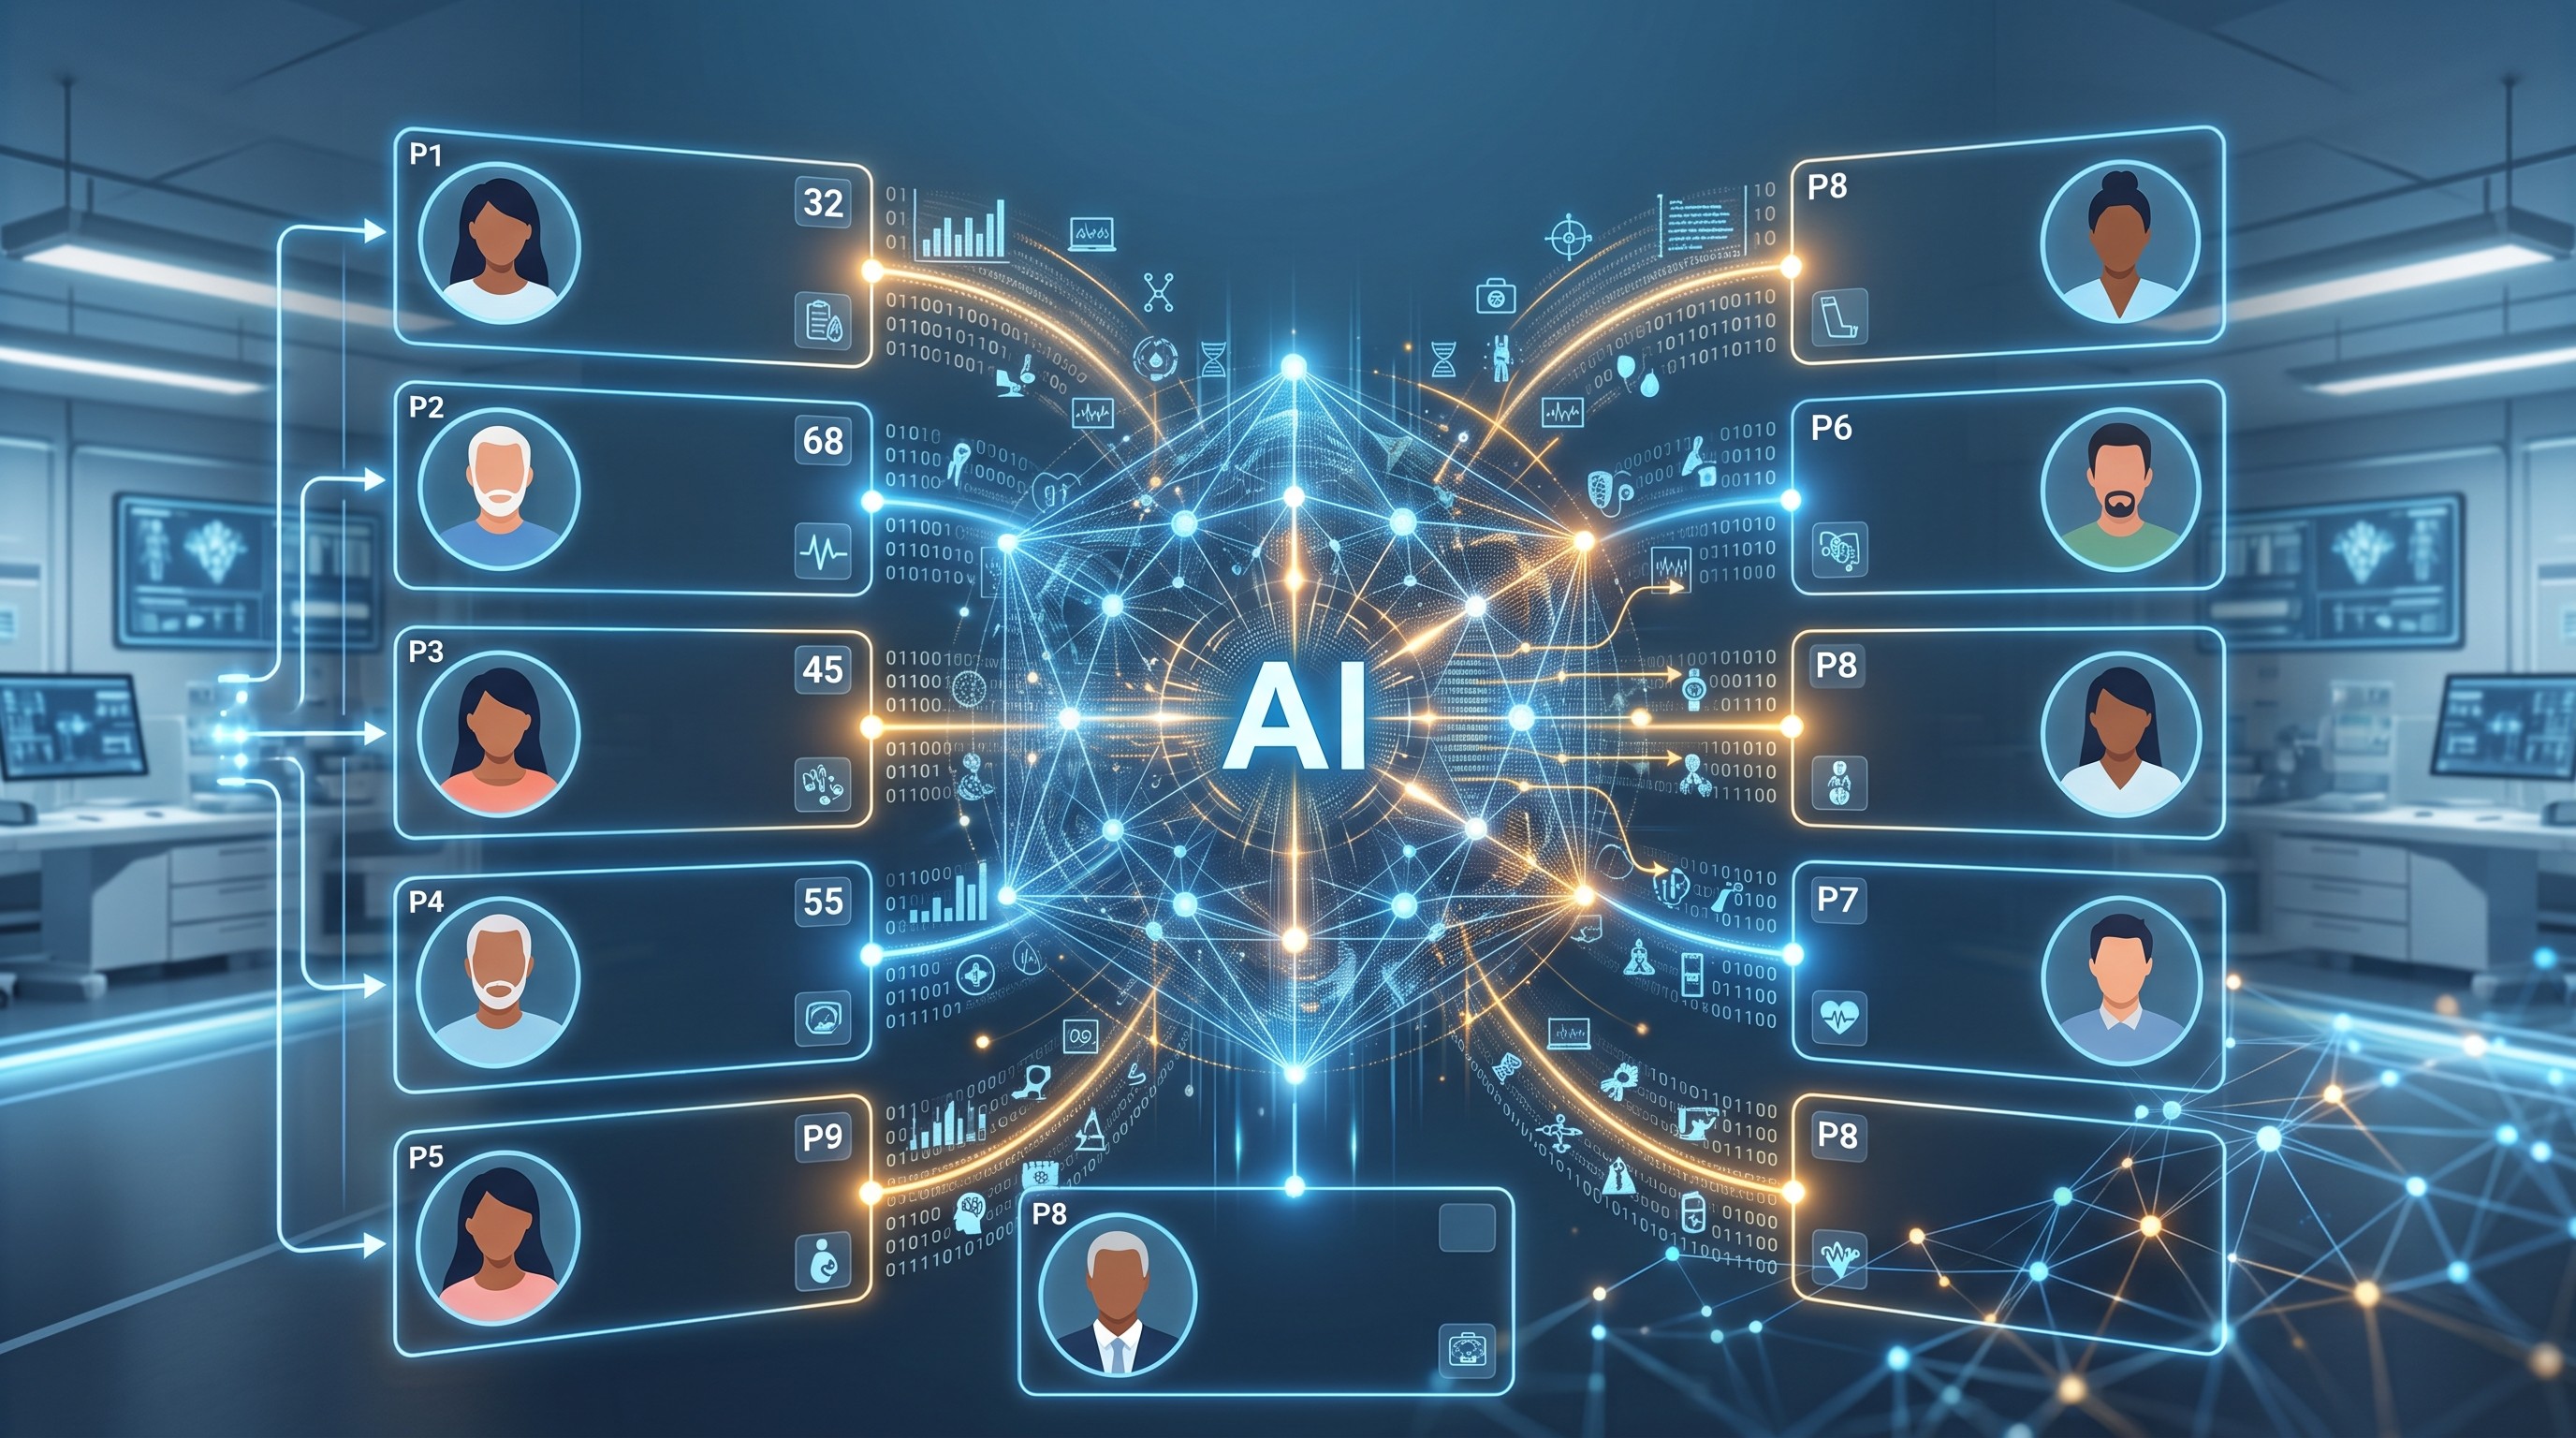

La inteligencia artificial en medicina puede presentar sesgos cuando se entrena con datos incompletos, poco representativos o que reflejan desigualdades existentes en el sistema sanitario. Estas distorsiones no suelen ser intencionadas. Aun así, pueden comprometer la precisión de los algoritmos para determinados grupos de pacientes.
Un modelo puede tener una exactitud global elevada y fallar de forma sistemática en determinadas franjas de edad, fototipos cutáneos o poblaciones atendidas fuera de los grandes centros de investigación. Estas diferencias no siempre aparecen en las métricas globales de rendimiento. A menudo solo se manifiestan cuando se analiza el comportamiento de los algoritmos por subgrupos, una práctica que aún no forma parte de todos los procesos de validación.
La inteligencia artificial está ampliando su presencia en la práctica clínica, apoyando desde la interpretación de pruebas hasta la documentación médica y la estratificación del riesgo. Para utilizar estas herramientas con seguridad, hay que comprender cómo se entrenaron los modelos y en qué poblaciones funcionan bien.
En este contexto cobra importancia el debate sobre el sesgo algorítmico, uno de los principales retos para adoptar la inteligencia artificial en medicina de forma segura.
Las cinco principales fuentes de sesgo en la IA aplicada a la salud son:
Datos poco representativos de determinados grupos de población.
Datos que reproducen desigualdades históricas en el acceso a la atención sanitaria.
Una variable objetivo mal elegida al entrenar el modelo.
Baja calidad o interoperabilidad de los datos entre sistemas.
Uso del modelo fuera del contexto en el que se validó.
¿Cuáles son las principales fuentes de sesgo en la inteligencia artificial en medicina?
Ningún algoritmo nace sesgado. En general, los problemas aparecen durante el desarrollo, cuando el modelo aprende a partir de bases de datos incompletas, variables mal definidas o contextos muy distintos de aquellos en los que se utilizará. Estos son los cinco orígenes más habituales del sesgo en la IA aplicada a la salud:
Datos poco representativos
Un algoritmo aprende a partir de los ejemplos que recibe. Si la base de entrenamiento reúne principalmente a pacientes atendidos en hospitales universitarios o grandes centros urbanos, su rendimiento puede disminuir al encontrarse con poblaciones poco representadas, como niños, personas mayores, personas negras, indígenas o pacientes de regiones remotas.
Este problema ya se ha descrito en distintas especialidades. En dermatología, por ejemplo, un estudio publicado en Science Advances mostró que los algoritmos obtenían peores resultados al evaluarse con imágenes de pacientes con fototipos más oscuros, lo que refuerza la importancia de bases de entrenamiento más diversas.
Datos que reproducen desigualdades históricas
Los algoritmos también aprenden de cómo funciona el sistema sanitario. Si determinados grupos tuvieron menos acceso a consultas, pruebas o especialistas, esas diferencias pasan a formar parte de la base de entrenamiento.
El riesgo es que la IA interprete las desigualdades de acceso como si fueran diferencias clínicas reales, perpetuando un problema que ya existía antes del algoritmo.
Una variable objetivo mal elegida
El error no siempre está en los datos. A veces está en aquello que se ha entrenado al modelo para predecir.
El ejemplo clásico se publicó en Science en 2019, en el artículo Dissecting racial bias in an algorithm used to manage the health of populations. Un algoritmo utilizaba el gasto en asistencia médica como indicador indirecto de la necesidad de cuidados complejos. Como los costes también reflejan desigualdades de acceso a los servicios sanitarios, los pacientes negros acababan clasificados con una prioridad inferior a la que realmente necesitaban.
Desde su publicación, el estudio se ha convertido en una de las principales referencias sobre sesgo algorítmico en salud, al mostrar que la elección inadecuada de una variable puede introducir sesgos importantes incluso cuando el algoritmo no utiliza la raza como dato de entrada.
Calidad e interoperabilidad de los datos
Las historias clínicas incompletas, las diferencias entre equipos, los protocolos distintos y los sistemas que no comparten información también afectan al rendimiento de los modelos.
Un algoritmo entrenado con datos muy estandarizados puede perder precisión al empezar a analizar registros producidos en otros hospitales o redes asistenciales. En estos casos, la limitación no está necesariamente en la IA, sino en la calidad y la coherencia de la información disponible.
Uso fuera del contexto de entrenamiento
Un modelo validado en un hospital universitario de alta complejidad no necesariamente rendirá igual en un hospital regional o en atención primaria.
Los cambios en el perfil epidemiológico, la disponibilidad de pruebas, los protocolos clínicos y la infraestructura pueden reducir su precisión. Por eso, los especialistas recomiendan que las herramientas de inteligencia artificial se validen en el entorno en el que se utilizarán y se supervisen de forma continua tras su implantación.
El sesgo no es solo un problema técnico: es institucional
Tratar el sesgo algorítmico como un defecto que se corregirá en la próxima actualización del software simplifica un problema mucho más amplio. Elegir las bases de entrenamiento, las variables que se predecirán, las métricas de rendimiento y los grupos incluidos en la validación son decisiones institucionales que influyen directamente en la calidad de los modelos.
Por eso, organizaciones como la Organización Mundial de la Salud (OMS) defienden que la evaluación de la equidad forme parte de todo el ciclo de vida de los sistemas de inteligencia artificial en salud. En Brasil, este debate también incluye la aplicación de la Lei Geral de Proteção de Dados (LGPD) y las orientaciones del Conselho Federal de Medicina (CFM), que mantienen en el médico la responsabilidad de la decisión clínica.
En la práctica, esto significa exigir algo más que buenas cifras de exactitud. Los hospitales y los profesionales necesitan conocer las limitaciones de los modelos, comprobar su rendimiento en distintos grupos de pacientes y hacer un seguimiento de sus resultados tras la implantación. Un algoritmo puede funcionar muy bien de media y, aun así, presentar fallos importantes en poblaciones concretas.
El objetivo no es eliminar por completo los sesgos, sino identificarlos, medirlos y reducirlos antes de que afecten a la atención al paciente. Esta es una de las condiciones para incorporar la inteligencia artificial a la práctica médica de forma segura, ética y basada en la evidencia.
Sigue leyendo
Comprender cómo surgen los sesgos es solo el primer paso para utilizar la inteligencia artificial en medicina con criterio. En los próximos artículos verás cómo estos problemas ya han afectado a decisiones clínicas y conocerás una lista práctica para evaluar las herramientas de IA antes de adoptarlas.
Preguntas frecuentes (FAQ)
¿Qué es el sesgo algorítmico en salud?
Es la tendencia de un sistema de inteligencia artificial a rendir de forma diferente entre grupos de pacientes. Suele ocurrir porque el modelo se entrenó con datos poco representativos, que reflejan desigualdades históricas o utilizan variables que no corresponden adecuadamente a la necesidad clínica.
¿Se puede eliminar por completo el sesgo en la inteligencia artificial en medicina?
No. Todos los conjuntos de datos tienen limitaciones. El objetivo es reducir estos sesgos mediante bases más representativas, validación en distintas poblaciones, auditorías periódicas y supervisión continua del rendimiento tras la implantación.
¿Cómo evaluar si una herramienta de IA puede presentar sesgos?
Antes de adoptarla, es importante comprobar si el modelo se ha validado en poblaciones similares a la atendida por la institución y solicitar resultados segmentados por edad, sexo, raza/etnia y otros subgrupos clínicos relevantes. Las métricas generales de rendimiento, por sí solas, pueden ocultar diferencias importantes entre poblaciones.
¿Sigue siendo el médico responsable de las decisiones tomadas con apoyo de la IA?
Sí. La inteligencia artificial es una herramienta de apoyo a la decisión clínica. La interpretación de los resultados, la elección de la actuación y la responsabilidad de la atención siguen correspondiendo al profesional sanitario.
Artículos relacionados